Visual Anagrams
アルチンボルト的な錯視の画像を生成するAIモデルを試してみた。
上下回転、フリップ、skewからジグソーパズルまで色々なバージョンが用意されている。
Images that Soundと同一の著者による論文。

Visual Anagrams
https://github.com/dangeng/visual_anagrams
Method
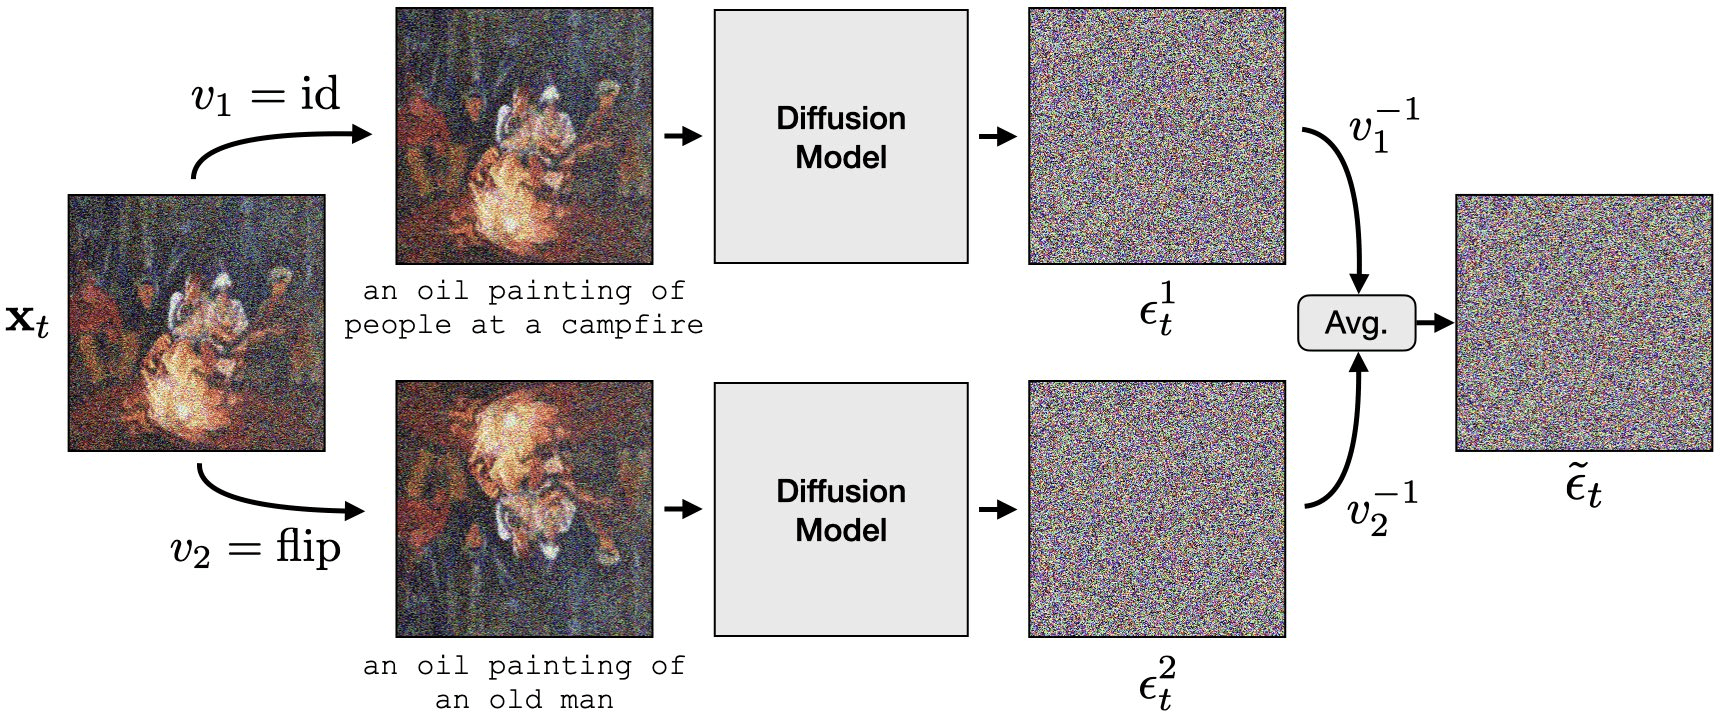
DiffusionモデルにはDeepFloydを使用。
理論的にはシンプルで、2種類の画像の平均予測を取って拡散ステップを計算している。
"a photo of…”のように、高精細な画像の生成は難しい。「キッチンの油画」などの抽象的なプロンプトの方がうまくいきやすい。「顔」は人間の錯視の感覚的なうまくいきやすいらしい(パレイドリア)。
Colab Demo
公式がlow RAM / high RAMの2つのノートブックを公開している。下記のOutput Samplesではlow RAMバージョンを使用した。
lowバージョンでは途中でText Encoderを削除してメモリを確保している模様。なのでプロンプトを変更して生成するには再度、最初から実行する必要がある。
- for Free Tier: Google Colab
- for Pro Tier: Google Colab
Output Samples
ステップ数やguidance scaleなどを工夫すればもう少し精度が上がるのかも。
Ref.
フーリエ変換的な手法? 上記と同じように回転したアナグラム版もある。

Diffusion Illusions: Hiding Images in Plain Sight
おまけ
ジグソーパズルはプリントして遊べるらしい。
発展版のFactorized Diffusionがコードは未公開だが、発表されている。