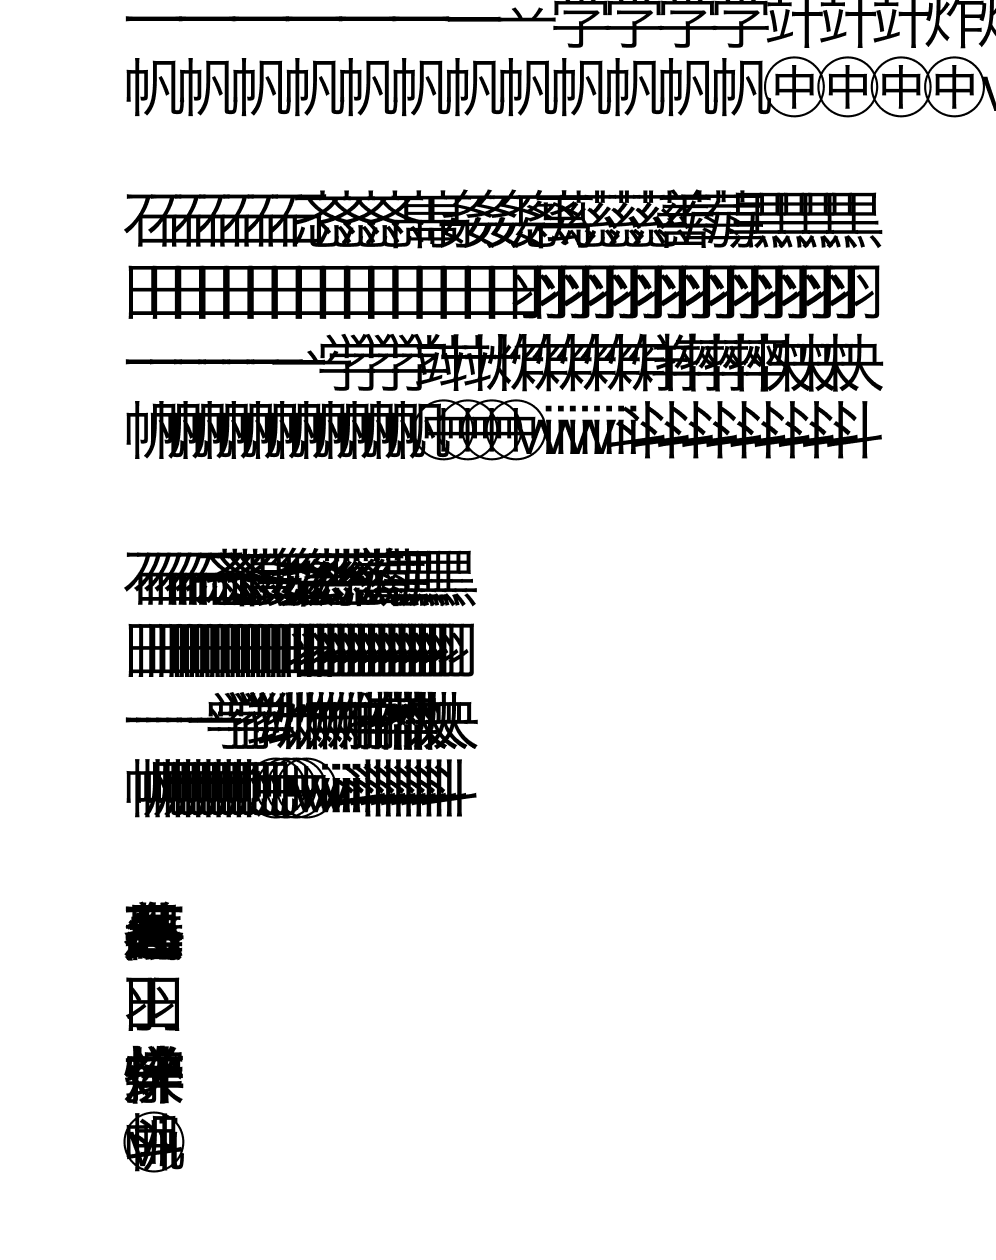
Glyph Similarity Analyzer
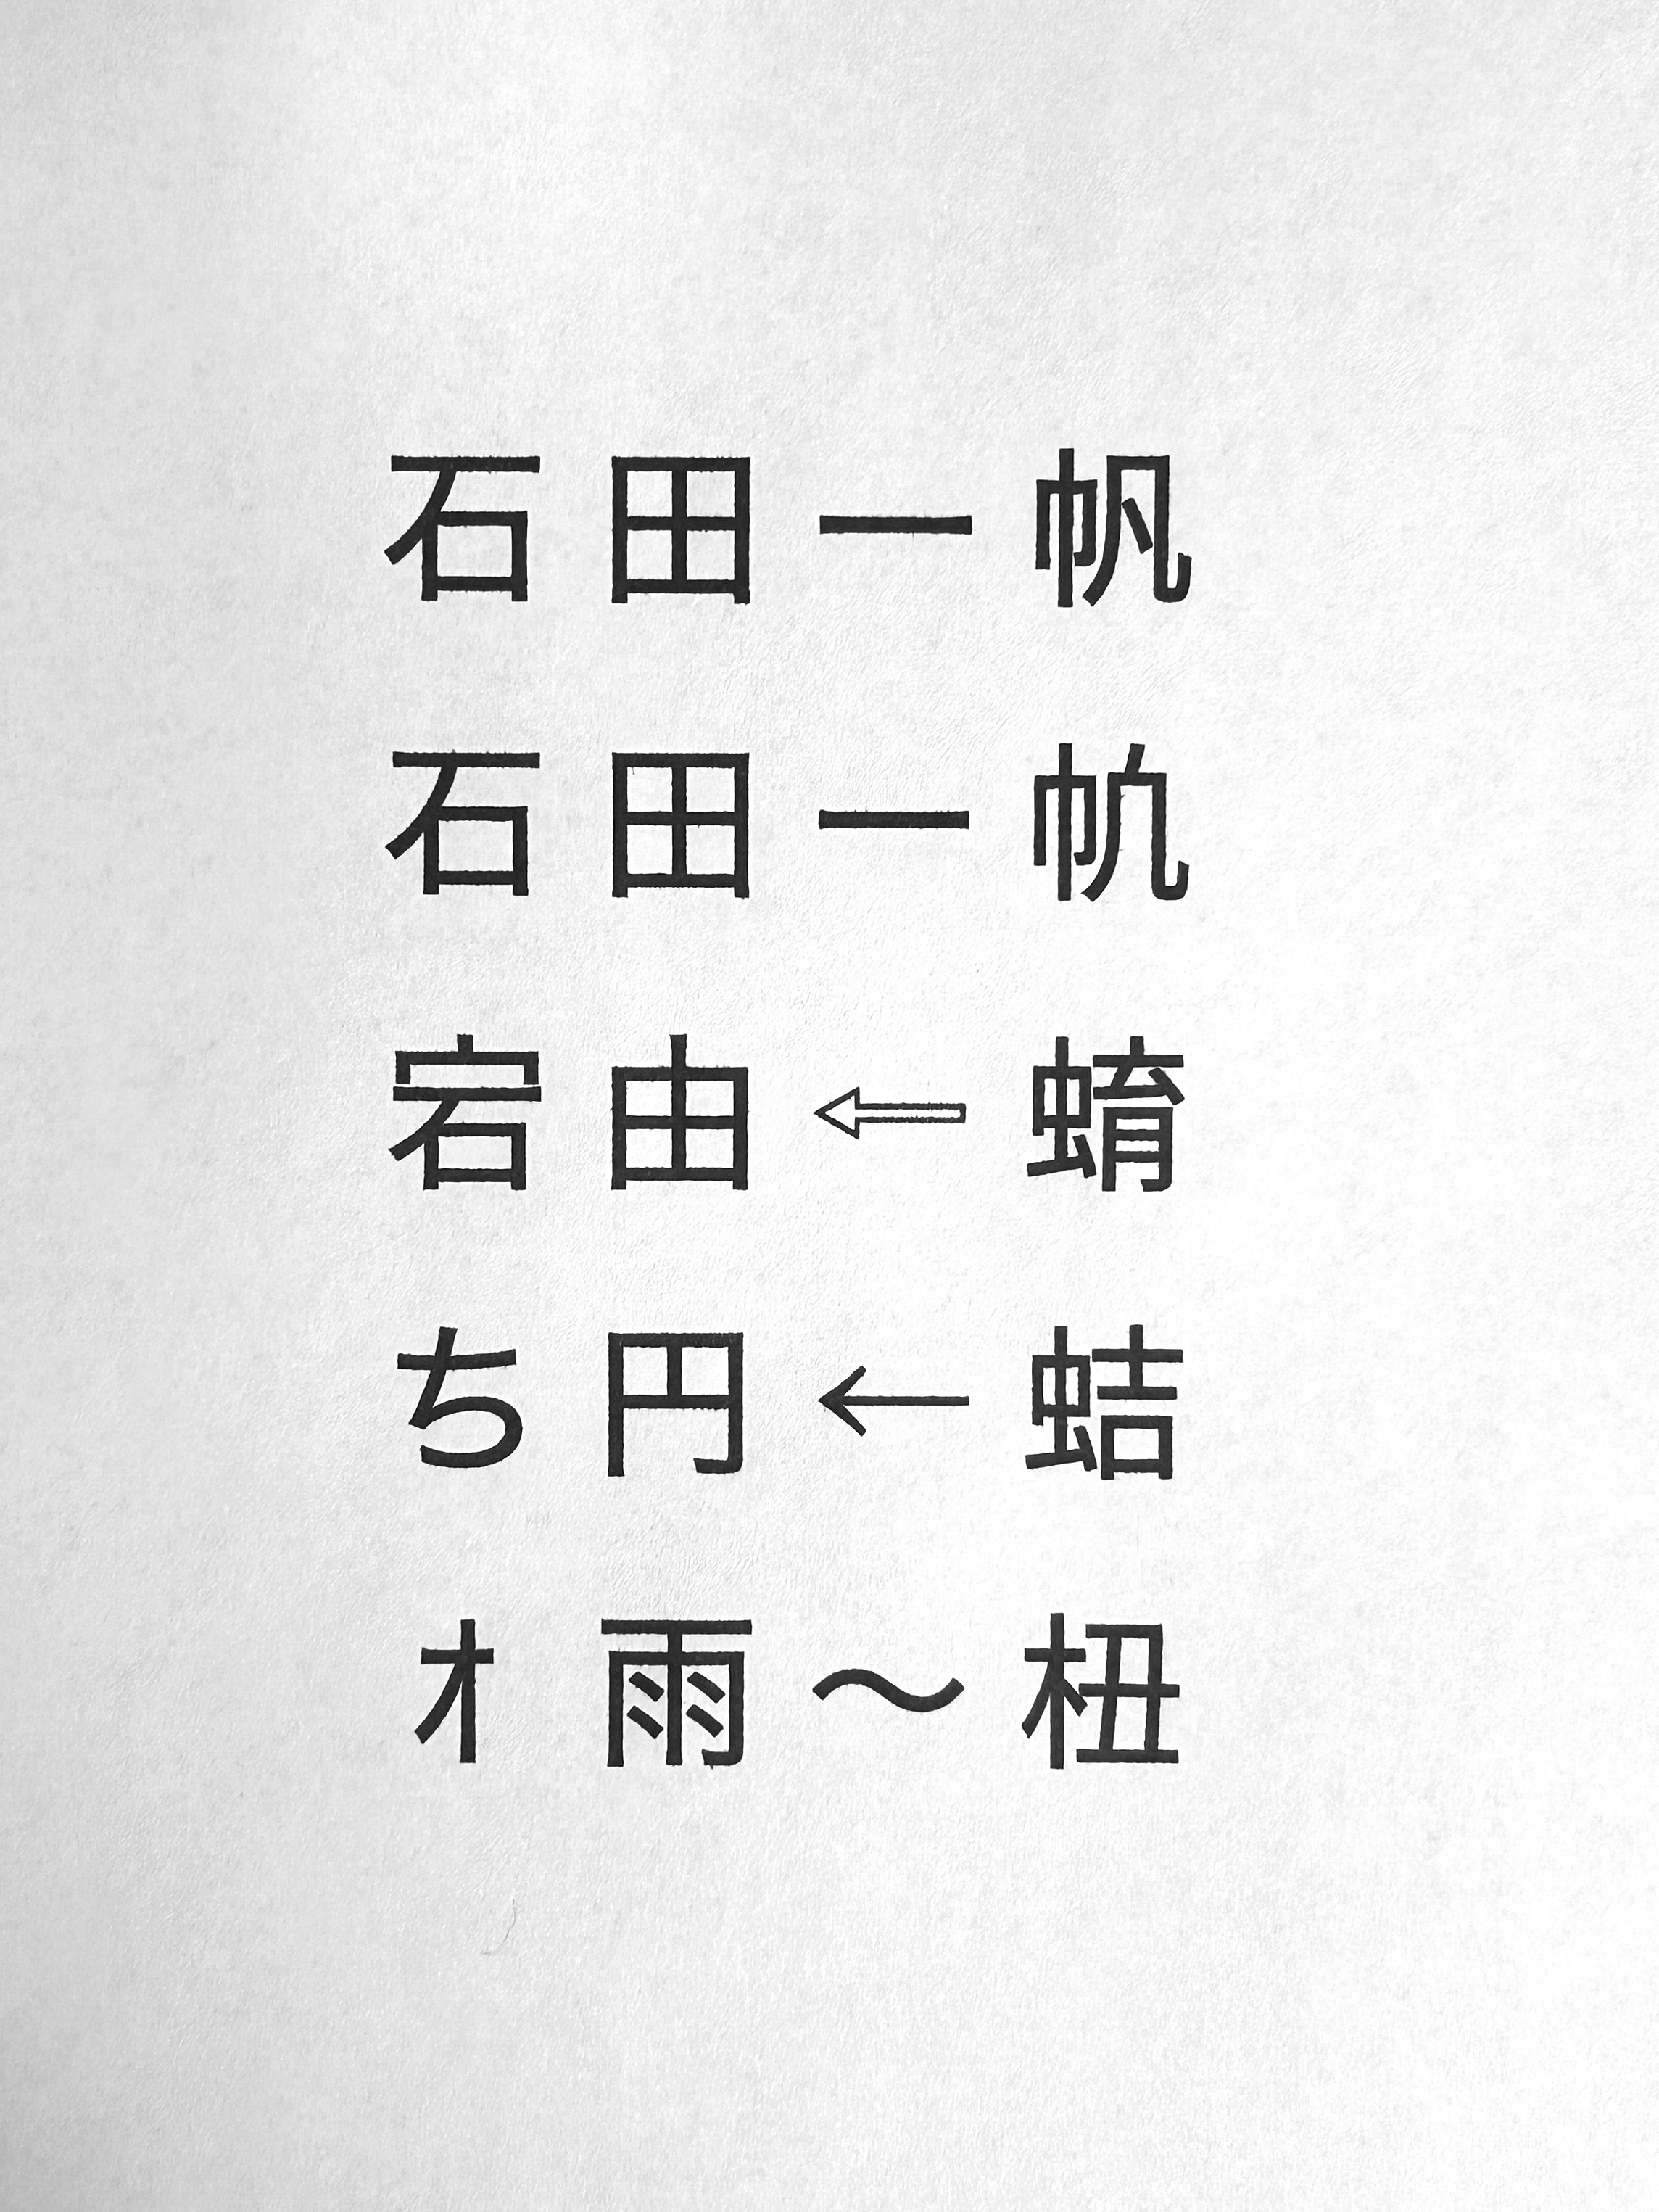
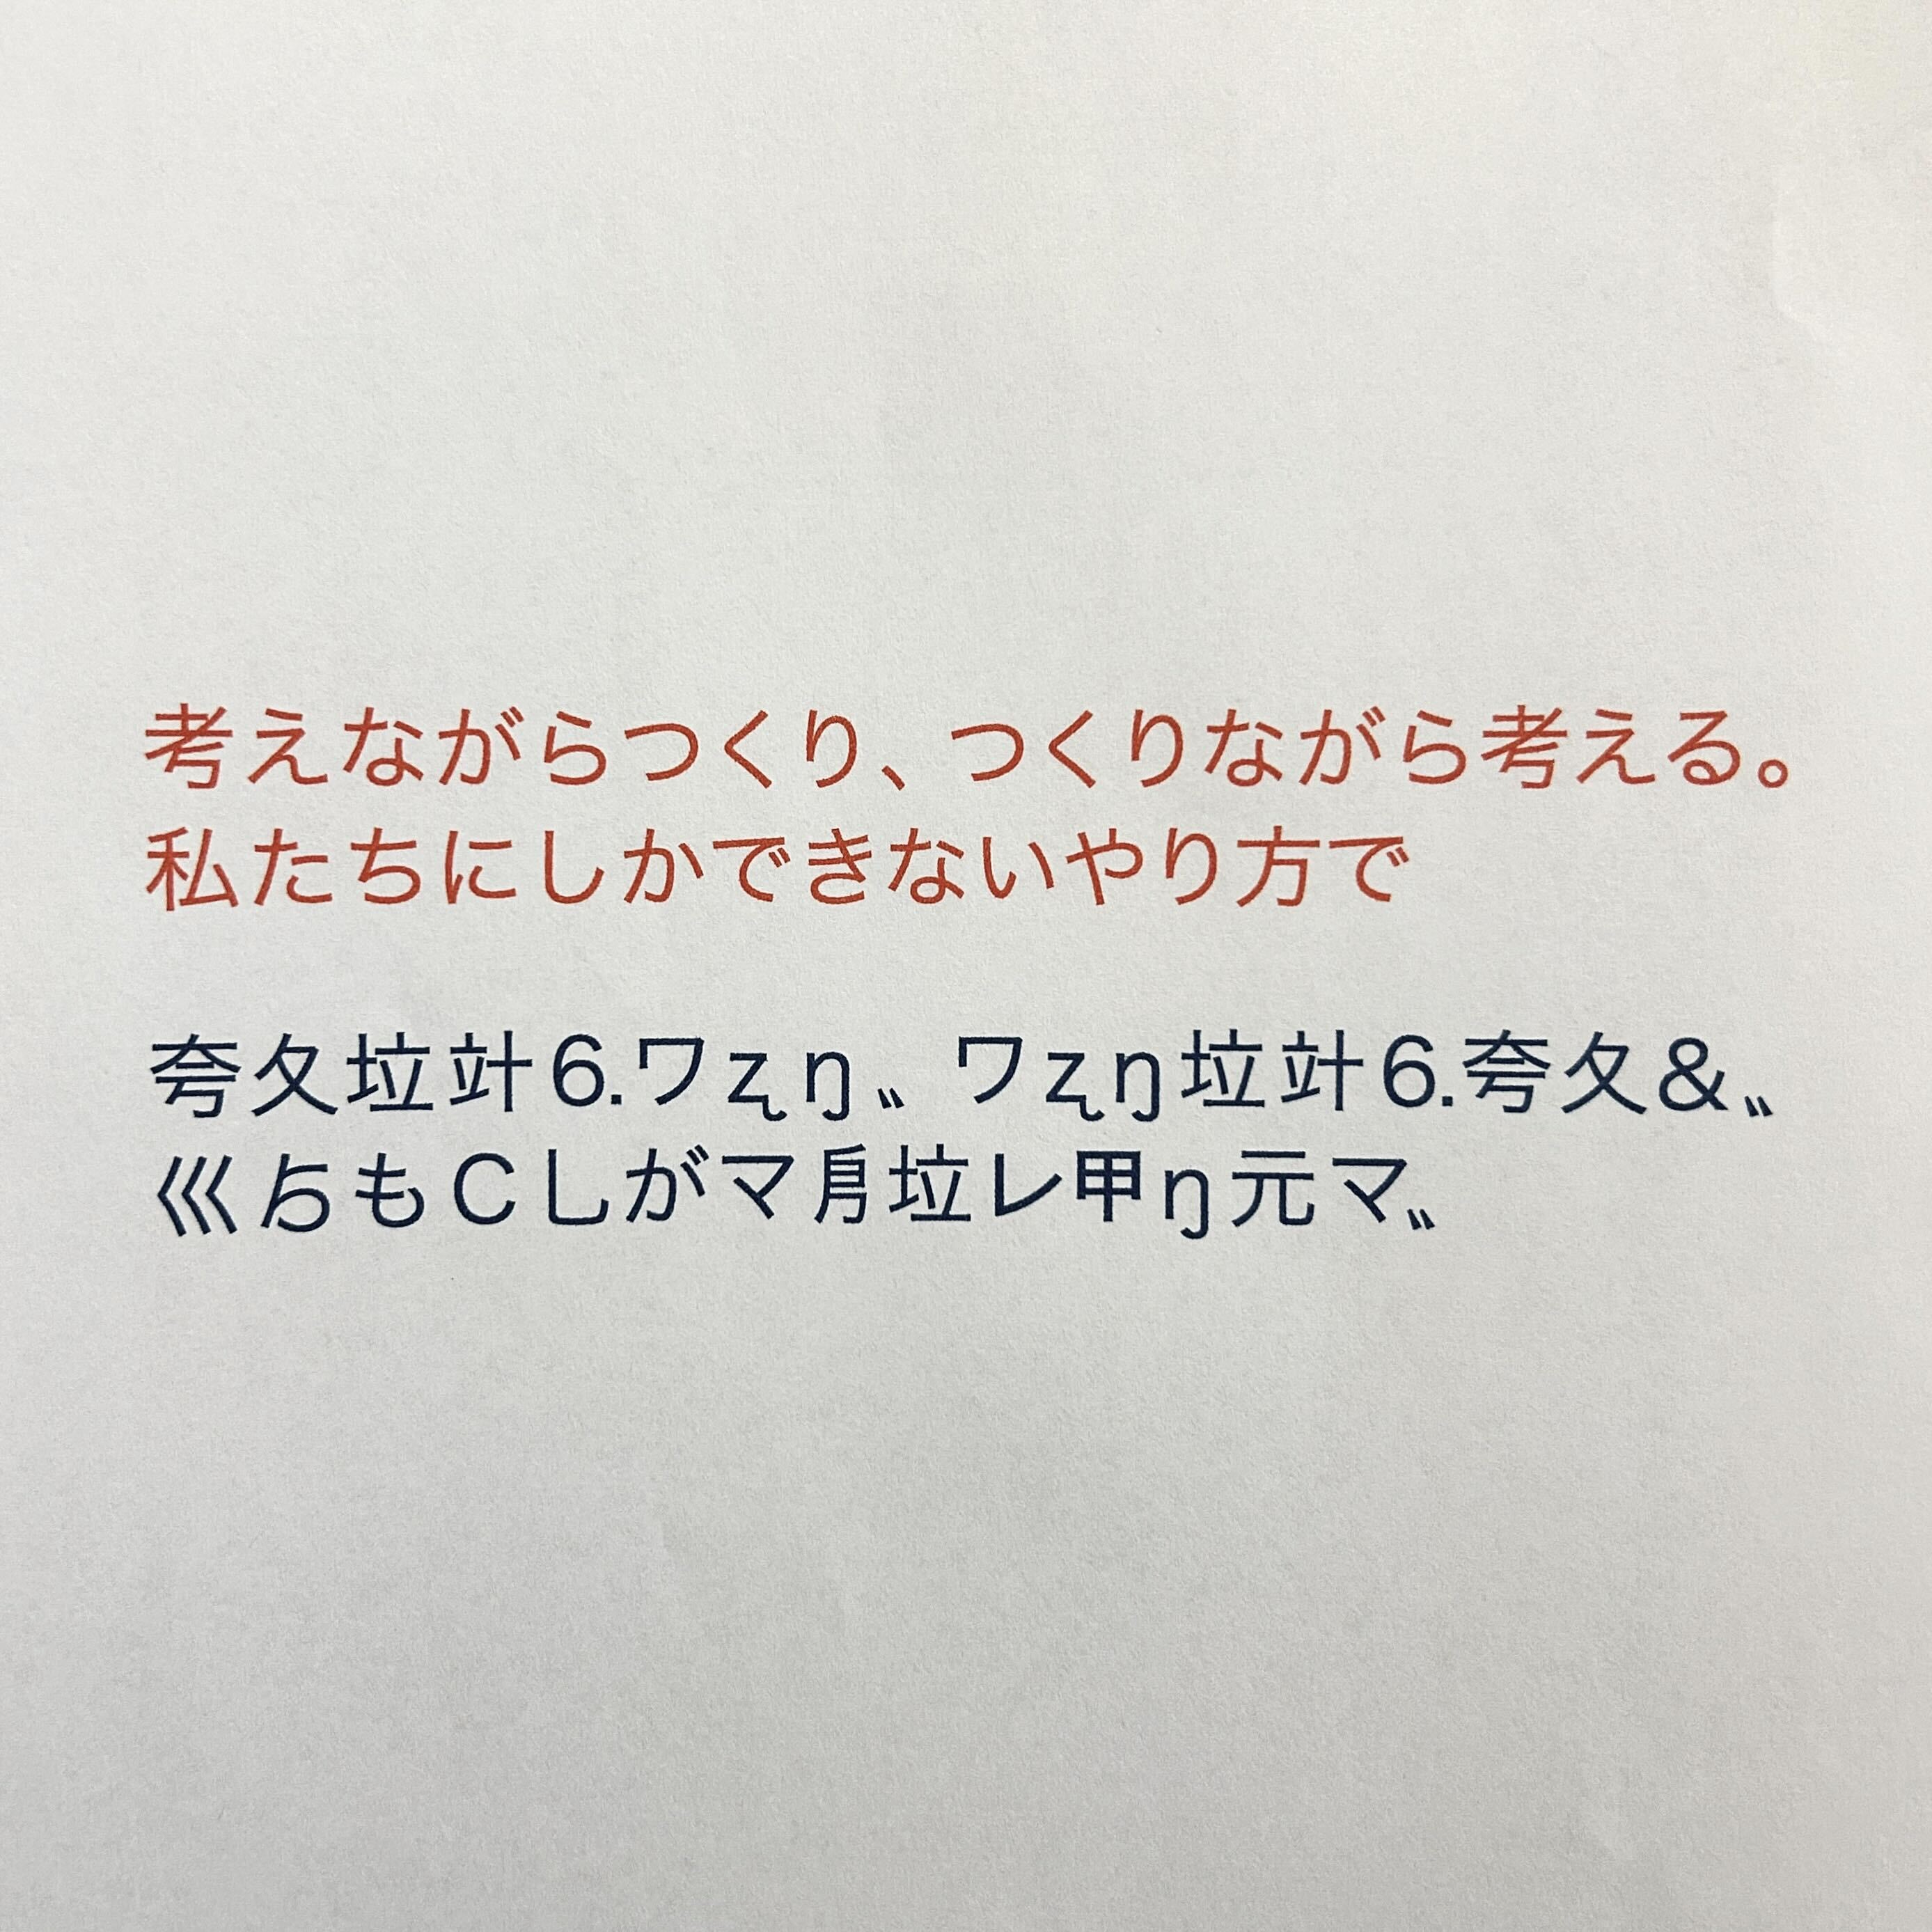
グリフの類似性を分析するための訓練/推論モデル。CNNベース。
inspired by 「かむかもしかもにどもかも!(imai remix)」Music Video
仕組み
分類問題として解かせる。
学習データはフォントファイルから自動で作る。1文字ずつ32×32に描き出したものがそのまま訓練画像になる。
文字を32×32に描くとき、textbbox で実際の描画範囲を測ってから中央に置いている。フォントのベースラインのまま描くと字ごとに位置がずれ、形ではなく位置の違いを学習してしまうため。
ヒラギノ角ゴ Pro W3で13670文字、100エポックで93%ほどの精度。
特殊文字を省く
https://ja.wikipedia.org/wiki/%E5%BA%B7%E7%85%95%E9%83%A8%E9%A6%96
# exclude control characters and whitespaces
category = unicodedata.category(normalized_char)
# exclude variation selectors: 異体字
variation_selector = 0xFE00 <= ord(normalized_char) <= 0xFE0F
# exclude kangxi radicals: 康煕部首
kangxi_radicals = 0x2F00 <= ord(normalized_char) <= 0x2FDF

if (not category.startswith('C') and
    not normalized_char.isspace() and
    not variation_selector and
    not kangxi_radicals):
    characters.add(normalized_char)
謎文字たちを除外する。Unicodeは範囲で特定のブロックを指定できるらしい。
unicodedata.normalize('NFC', char)を用いて、文字を正規化していたけれど、これは間違い。NFC(Normalization Form Canonical Composition)は、文字を正準等価性に基づいて正規化し、可能な限り合成するらしい。
άέ ←こういうやつみたく結合される
モーフィング
徐々に変わるグリフでスリンキー